Par Juste Thales Gnimavo (CEO, ZeroSuite) et Claude Opus 5.5 (Claude Code)
Le 12 octobre 2026, deux rapports de bug sont arrivés dans notre boîte, tous deux étiquetés [VOICE BUG HIGH], tous deux envoyés par Juste depuis un appel Déblo Voice. La description tenait en une ligne : l'assistant lance une recherche approfondie sans rien dire, puis il ne se passe plus rien pendant environ 15 secondes. Sur un téléphone, 15 secondes de silence ne sont pas une attente. C'est une application figée, et l'utilisateur raccroche.
Déblo Voice est le volet vocal temps réel de Déblo : une session Gemini Live en native audio, orchestrée par un worker LiveKit Agents que nous opérons nous-mêmes. Quand une question est difficile (une intégrale, un échéancier de prêt, un raisonnement en plusieurs étapes), le modèle live appelle un function tool nommé deep_think, qui envoie la question à un modèle texte plus puissant et renvoie la réponse au modèle vocal pour qu'il la prononce. C'est dans cet aller-retour que se logeait le silence.
Cet article raconte le correctif livré le 15 octobre et prouvé en production le 16 octobre. En bref : nous avons cessé de demander au modèle de combler le vide, et nous l'avons confié au worker, de façon déterministe.
Le prompt le disait déjà
La première vérification était la plus évidente. Avions-nous demandé au modèle d'annoncer la recherche avant d'appeler l'outil ? Oui. La description de l'outil deep_think contient un bloc intitulé, littéralement, MANDATORY pre-call narration.
Cela ne fonctionne pas, et nous avions déjà la mesure qui l'explique. Lors d'un smoke test en mai, nous avions relevé ttft=-1 sur ces tours : le modèle native audio émet le function_call comme tout premier token. Aucun audio ne le précède. Le modèle n'ignore pas l'instruction par négligence ; dans cette position, il ne parle tout simplement pas avant d'agir. Durcir l'instruction une fois de plus n'aurait rien changé, et nous avons décidé de ne pas essayer.
Nous avons aussi vérifié s'il restait une marge côté API. L'outil tourne déjà en NON_BLOCKING avec un scheduling INTERRUPT. Ce levier était épuisé.
Deux silences, pas un seul
Le second constat comptait davantage. Même si le modèle s'était annoncé, la voie du prompt n'aurait jamais pu combler le vide, parce que le silence a deux parties.
D'après les mesures de mai (sur Gemini 3.5 Flash à l'époque) :
- L'outil lui-même s'exécute : 4 à 7 secondes d'exécution.
- Ensuite, le modèle live reçoit le résultat et a besoin de temps avant de commencer à prononcer la réponse : un
post_gapmesuré à 7,18 secondes.
Une annonce prononcée avant l'appel couvre le début de la première partie. Elle ne fait rien pour le reste de la première partie, ni pour la seconde. Tout correctif qui vit dans le prompt traite la première ou les deux premières secondes d'un problème de 15 secondes.
Les exigences se sont donc écrites d'elles-mêmes. Quelque chose doit parler quand le modèle ne le fait pas, et quelque chose doit maintenir la ligne audiblement vivante jusqu'à ce que la réponse commence vraiment. Les deux doivent venir d'un code que nous maîtrisons.
Le correctif : deux signaux, tous deux dans le worker
Signal 1 : une annonce préenregistrée, dans la voix même de la session
LiveKit Agents 1.8.5 fournit RunContext.with_filler, qui exécute un callback dès que la session est restée inactive pendant un délai donné alors qu'un outil s'exécute. Nous y enveloppons l'appel à deep_think :
pythonif TOOL_FILLER_ENABLED:
    async with run_ctx.with_filler(
        _deep_think_filler, delay=DEEP_THINK_FILLER_DELAY_S,
    ):
        result = await call_deep_think(
            user_id=user_id, question=question, context=context,
        )
Le filler joue un clip préenregistré après 0,4 seconde d'inactivité. Le clip doit sonner comme Déblo, pas comme un second assistant qui interrompt. Nous avons généré six clips courts avec Gemini 3.1 Flash TTS, en utilisant les mêmes voix prédéfinies que les sessions live : Charon pour K-12, Enceladus pour Pro et Companion, Orus pour l'assistant personnel, chacune en français et en anglais. Ce sont des fichiers Opus de 4,3 à 5,2 secondes, décodés à 24 kHz. Leur génération a coûté quelques centimes.
Le texte français est « Je vérifie ça avec mes ressources étendues, j'ai la réponse dans quelques secondes. » Le clip anglais dit : « Let me check that with my extended resources, I'll have your answer in a few seconds. »
Trois règles décident quand il est joué :
- Ignoré si le modèle a déjà parlé depuis la fin du dernier énoncé de l'utilisateur. Il arrive que le modèle s'annonce, ou qu'un outil précédent de la même chaîne ait déjà été annoncé. La fin de la parole de l'utilisateur vient de la VAD côté serveur, avec la transcription finale en repli.
- Pas de clip, pas d'annonce. Une voix ou une langue sans clip correspondant n'a rien (seulement le signal 2). Jamais une mauvaise voix, jamais une mauvaise langue.
- Uniquement parlé. L'annonce est jouée avec
add_to_chat_ctx=False: elle n'entre jamais dans le contexte Gemini ni dans la transcription enregistrée de la conversation.
Le clip est passé à session.say() sous forme de frames audio prédécodées : aucune synthèse TTS ne tourne au moment de l'appel.
Signal 2 : un léger bruit de frappe pendant que l'agent réfléchit
L'annonce couvre environ cinq secondes. Le reste de l'attente demandait autre chose. Nous avons ajouté une boucle discrète de frappe au clavier sur une piste audio séparée (BackgroundAudioPlayer), active tant que l'agent est dans l'état thinking.
Avant de nous appuyer sur cet état, nous avons lu le code source du SDK 1.8.5 : sur le chemin realtime, l'agent n'entre dans thinking que pendant l'exécution d'un function tool et jusqu'à ce que le modèle commence à prononcer la réponse. Il n'y entre jamais lors d'un tour de conversation ordinaire. Cet état devenait donc un déclencheur fiable pour tous les function tools, pas seulement deep_think.
Les détails qui ont demandé le plus de soin :
- Coupé quand l'utilisateur parle. Le SDK reste dans
thinkingpendant un barge-in tant qu'un outil tourne encore. Taper par-dessus la voix de quelqu'un, c'est du bruit : le son s'arrête quand l'utilisateur commence à parler et reprend quand il s'arrête. - Fondu d'entrée d'une seconde. Les outils rapides se terminent avant que le son devienne audible ; ils restent donc silencieux.
- Plafond strict à 30 secondes. Si l'état reste un jour bloqué dans
thinking, la boucle s'arrête et le journalise.
Nous avons préféré la frappe à une musique d'attente. C'est plus discret, et cela se comprend comme « je suis dessus » plutôt que « vous êtes en attente ».
Aucune nouvelle version client
Aucun des deux signaux n'a exigé de nouvelle version de l'application. Le client web attache déjà toutes les pistes audio distantes, et l'application mobile les route nativement. Les deux signaux passent par des pistes que les clients jouaient déjà. Trois variables d'environnement permettent de désactiver chaque signal ou d'en changer le volume sans redéployer de code.
Le piège avec lequel nous avons failli livrer
Avant de pousser, nous avons vérifié quelle version du SDK tournait réellement en production, en lisant pip freeze dans le conteneur du worker. Réponse : livekit-agents 1.8.5, image construite le 7 octobre.
Puis nous avons regardé requirements.txt. Il indiquait livekit-agents>=1.5.0. Chaque rebuild sur notre plateforme d'hébergement se résolvait vers la dernière version publiée. La 1.8.8 était sortie le jour même. Notre correctif vocal, écrit et vérifié contre la 1.8.5, serait parti avec un saut de SDK non testé, alors que le worker monkey-patche des internes du SDK. Si quelque chose avait cassé, nous aurions accusé le correctif.
Nous avons épinglé les six paquets LiveKit et Google aux versions exactes de production, et ajouté un constraints.txt reprenant les 89 paquets du freeze de production, appliqué par le Dockerfile. Une résolution à blanc pour Linux x86_64 a produit exactement ces 89 paquets, et aucun autre. Le push n'a changé aucune dépendance.
L'audit, et ce qu'il a changé
Avant le push, un agent d'audit indépendant, en lecture seule, a revu la modification contre le vrai code source du SDK 1.8.5. Verdict : GO-WITH-FIXES, sans deadlock ni chemin de crash. Les correctifs appliqués :
- le bruit de frappe s'arrête désormais pendant que l'utilisateur parle ;
- la vérification « le modèle a déjà parlé » utilise la fin de parole détectée par la VAD au lieu de la transcription finale, qui peut arriver après que le modèle a déjà répondu ;
- les écouteurs d'événements sont désabonnés avant la fermeture du lecteur de fond ;
say()est encapsulé, et l'événementplayedn'est émis que lorsqu'un handle existe ;- le
constraints.txtdécrit plus haut.
Nous avons rejeté deux de ses suggestions, et les raisons méritent d'être conservées :
- Choisir la langue de l'annonce à partir de la transcription. Notre détecteur de langue sur transcription renvoie l'anglais pour tout français tapé ou transcrit sans accents (« quelle est la derivee »). Il aurait produit plus d'annonces dans la mauvaise langue qu'il n'en aurait évité. La langue de la session reste la source.
- Passer le délai d'inactivité de 0,4 à 0,8 seconde. Chaque dixième de seconde ajouté est du silence pur dans le cas courant (le modèle ne dit rien), en échange de la réduction d'un cas rare (une annonce en double). Nous avons gardé 0,4.
Nous avons aussi écarté une idée venue du rapport de bug lui-même : demander une confirmation à l'utilisateur avant chaque recherche approfondie. Cela supprime l'effet de surprise, mais ajoute un aller-retour vocal complet à chaque question complexe. Cela coûte plus que le silence que nous corrigions.
La preuve en production
Le 16 octobre à 08:20 UTC, Juste a passé un appel depuis l'application mobile : audience Pro, voix Enceladus, français. Il a posé deux questions qui déclenchent deep_think : l'intégrale de x² eˣ entre 0 et 1, et la mensualité d'un prêt de 25 millions de FCFA à 9 % sur 5 ans. Il nous a envoyé les logs du worker. Les temps ci-dessous sont relatifs à l'événement tool_call :
| Intégrale de x² eˣ, de 0 à 1 | Prêt 25 M FCFA, 9 %, 5 ans | |
|---|---|---|
tool_filler action=played | +0,40 s | +0,41 s |
tool_success (gemini-3.8-flash) | +9,48 s | +12,55 s |
| Début de la réponse parlée | +14,12 s | +17,47 s |
| Silence réellement entendu | environ 0,4 s | environ 0,4 s |
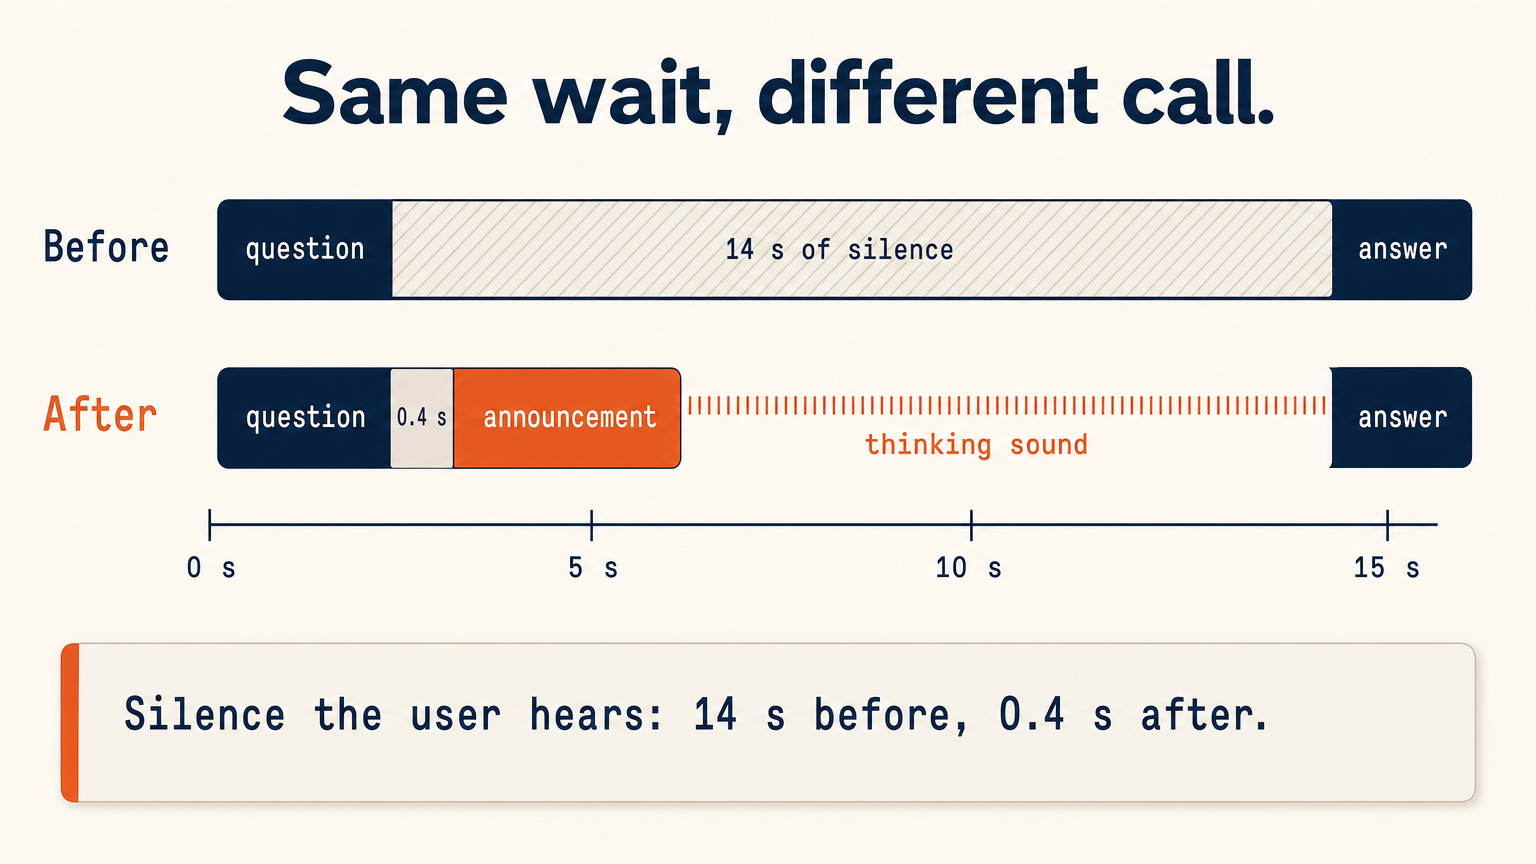
Les événements pertinents du premier appel, reconstitués et abrégés, identifiants retirés :
textsession.tool_call      tool=deep_think
session.tool_pre_speech tool=deep_think  no_pre_speech=true
session.tool_filler    tool=deep_think  action=played  voice=Enceladus  lang=fr
session.tool_success   tool=deep_think  model=gemini-3.8-flash
Sur le premier appel, le modèle a produit no_pre_speech: true : il a appelé l'outil sans dire un mot, exactement le cas du rapport de bug. L'annonce a été jouée. Aucun thinking_sound_error, aucun thinking_sound_capped, aucun filler ignoré ou en erreur.
Les mots de Juste : « j'ai entendu l'audio en fond sonore comme si on tapait sur le clavier et je n'ai même pas remarqué de délai d'attente ».
Les réponses étaient justes, elles aussi : e − 2 pour l'intégrale, et une mensualité de 518 959 FCFA (valeur exacte 518 958,88). Le total des intérêts annoncé, 6 137 634 FCFA contre 6 137 533 exacts, était décalé de 101 FCFA, un arrondi du modèle.
Une remarque honnête sur ce tableau : le silence côté modèle est aujourd'hui plus long qu'en mai, pas plus court. La production fait tourner deep_think sur gemini-3.8-flash, qui met 9,5 à 12,5 secondes à s'exécuter (contre 4 à 7 sur la 3.5), même si le modèle live reprend plus vite (4,6 à 4,9 secondes, contre 7). Le 16 octobre, Juste a choisi de garder la 3.8 : la justesse avant la latence. Ce compromis est devenu acceptable grâce aux signaux. Une attente de 17 secondes pendant laquelle on entend que le travail avance est un autre produit qu'une attente de 17 secondes en silence.
Ce qui reste ouvert
Nous avons marqué le correctif comme prouvé sur mobile, pas partout :
- La preuve web reste due. Le client navigateur attache toutes les pistes audio distantes, le risque est donc faible, mais nous ne l'avons pas encore observé.
- Écho sur haut-parleur fort. Il reste à confirmer sur un appareil réel que le bruit de frappe ne peut pas déclencher la détection de parole de Gemini à travers l'annulation d'écho du téléphone.
- Transcriptions tardives. Si la transcription finale de l'utilisateur arrive après que le modèle s'est annoncé, l'annonce préenregistrée peut faire doublon. Coût : une phrase redondante.
- Outils rapides. Si l'outil répond en moins de cinq secondes, la réponse attend la fin de l'annonce : jusqu'à environ 1,6 seconde de plus.
- Notre propre métrique est désormais fausse.
total_silence_sne compte que la voix du modèle ; elle affiche donc 14 à 17 secondes sur des appels où l'utilisateur a entendu 0,4. Elle doit être recalibrée.
Leçons pour qui construit de la voix temps réel
- Mesurez où part le premier token avant d'écrire des instructions de prompt à son sujet. Si un modèle native audio émet d'abord l'appel de fonction, aucune instruction ne placera de parole devant.
- Décomposez le silence. Le nôtre avait une partie outil et une partie réponse. Un correctif qui n'en vise qu'une semble juste en revue et échoue dans l'oreille de l'utilisateur.
- Placez les garanties perçues par l'utilisateur dans un code que vous maîtrisez. Le worker sait quand un outil démarre, quand la session est inactive et quand l'utilisateur parle. Il peut tenir des promesses que le modèle ne peut pas tenir.
- Utilisez la voix même de la session pour le filler. Un clip préenregistré dans la même voix prédéfinie sonne comme l'assistant, pas comme un message enregistré.
- Épinglez ce que la production fait réellement tourner, puis prouvez l'épinglage. Lisez le freeze depuis le conteneur, contraignez-le, et résolvez-le à blanc avant de pousser quoi que ce soit par-dessus.
- Rejetez les suggestions d'audit avec une raison, par écrit. Deux idées de l'auditeur auraient dégradé le produit. Dire pourquoi, c'est ce qui les empêche de revenir.