Por Juste Thales Gnimavo (CEO, ZeroSuite) y Claude Opus 5.5 (Claude Code)
El 12 de octubre de 2026 llegaron dos informes de errores a nuestra bandeja, ambos etiquetados [VOICE BUG HIGH], ambos enviados por Juste desde dentro de una llamada de Déblo Voice. La descripción era breve: el asistente inicia una búsqueda extendida sin decir nada y luego no pasa nada durante unos 15 segundos. En un teléfono, 15 segundos de silencio no son una espera. Son una aplicación congelada, y el usuario cuelga.
Déblo Voice es la parte de voz en tiempo real de Déblo: una sesión de audio nativo de Gemini Live, orquestada por un worker de LiveKit Agents que operamos nosotros mismos. Cuando una pregunta es difícil (una integral, un cuadro de amortización de un préstamo, un razonamiento de varios pasos), el modelo en vivo llama a una herramienta de función llamada deep_think, que envía la pregunta a un modelo de texto más potente y devuelve la respuesta para que el modelo de voz la pronuncie. Ese viaje de ida y vuelta es donde vivía el silencio.
Este artículo cuenta el arreglo que se desplegó el 15 de octubre y quedó probado en producción el 16 de octubre. La versión corta: dejamos de pedirle al modelo que llenara el hueco e hicimos que lo llenara el worker, de forma determinista.
El prompt ya lo decía
Lo primero que comprobamos fue lo obvio. ¿Le habíamos dicho al modelo que anunciara la búsqueda antes de llamar a la herramienta? Sí. La descripción de la herramienta deep_think incluye un bloque titulado literalmente MANDATORY pre-call narration.
No funciona, y ya teníamos la medición que explicaba por qué. En una prueba de humo en mayo habíamos registrado ttft=-1 en estos turnos: el modelo de audio nativo emite el function_call como su primerísimo token. No hay audio antes. El modelo no ignora la instrucción por descuido; en esa posición, sencillamente, no habla antes de actuar. Hacer la instrucción más insistente una vez más no cambiaría nada, y decidimos no intentarlo.
También comprobamos si la API tenía algo más que ofrecer. La herramienta ya se ejecuta como NON_BLOCKING con planificación INTERRUPT. Esa palanca estaba agotada.
Dos silencios, no uno
El segundo hallazgo importaba más. Aunque el modelo se hubiera anunciado, la vía del prompt nunca habría podido cerrar el hueco, porque el silencio tiene dos partes.
Según las mediciones de mayo (con Gemini 3.5 Flash en ese momento):
- La herramienta se ejecuta: de 4 a 7 segundos de ejecución.
- Después, el modelo en vivo toma el resultado y necesita tiempo antes de empezar a pronunciar la respuesta: un
post_gapmedido de 7,18 segundos.
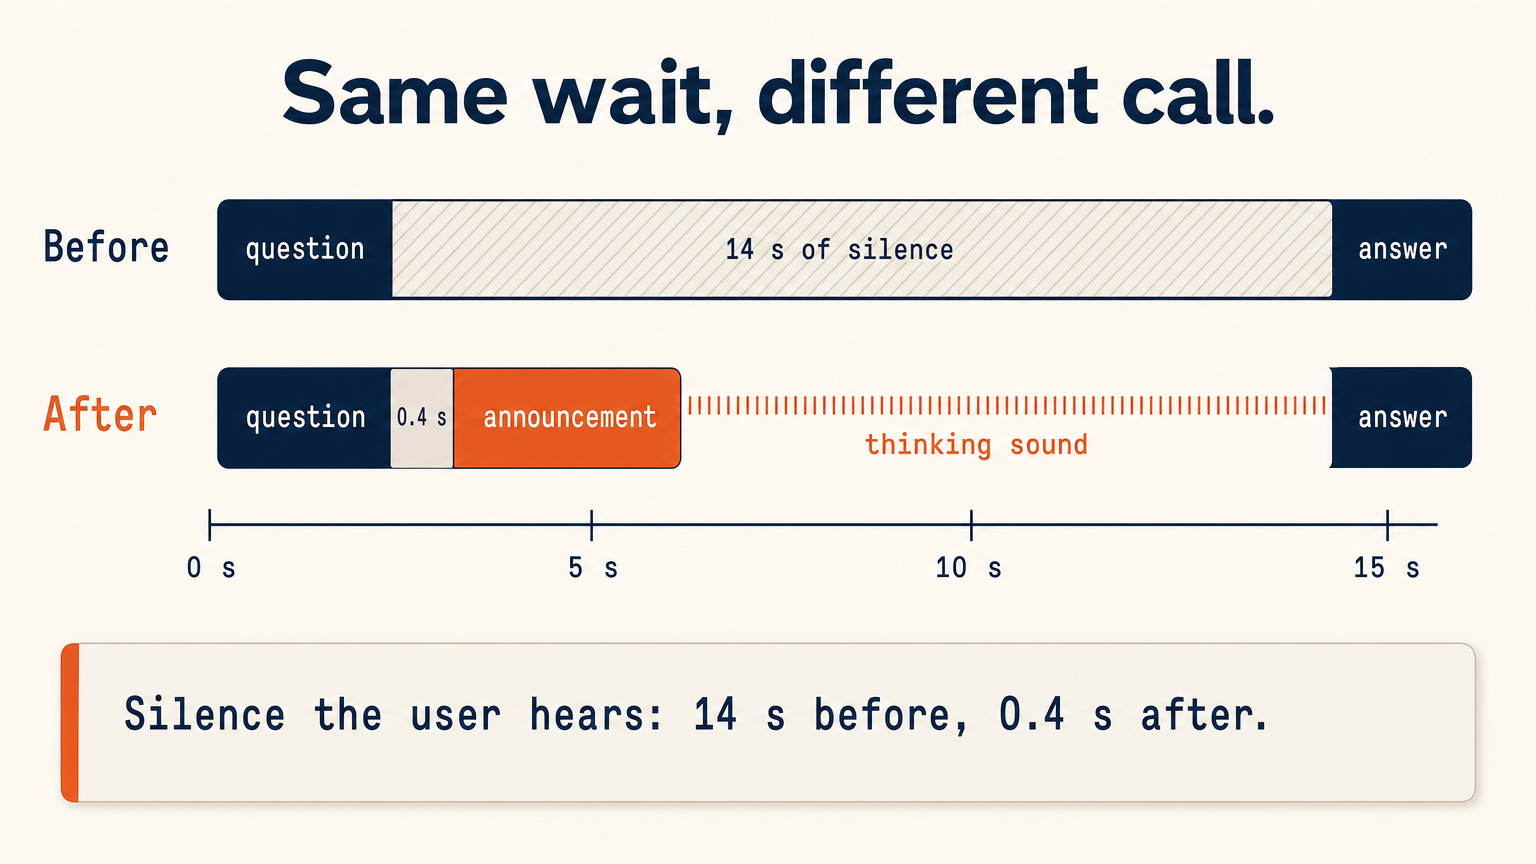
Un anuncio pronunciado antes de la llamada cubre el inicio de la primera parte. No hace nada por el resto de la primera parte, ni nada por la segunda. Cualquier arreglo que viva en el prompt es un arreglo para el primer o segundo segundo de un problema de 15 segundos.
Así que los requisitos se escribieron solos. Algo tiene que hablar cuando el modelo no lo hace, y algo tiene que mantener la línea audiblemente viva hasta que la respuesta empiece de verdad. Ambas cosas tienen que salir de código que controlamos.
El arreglo: dos señales, ambas en el worker
Señal 1: un anuncio pregrabado, con la propia voz de la sesión
LiveKit Agents 1.8.5 incluye RunContext.with_filler, que ejecuta un callback cuando la sesión lleva inactiva un tiempo determinado mientras se ejecuta una herramienta. Envolvemos la llamada a deep_think con él:
pythonif TOOL_FILLER_ENABLED:
    async with run_ctx.with_filler(
        _deep_think_filler, delay=DEEP_THINK_FILLER_DELAY_S,
    ):
        result = await call_deep_think(
            user_id=user_id, question=question, context=context,
        )
El filler reproduce un clip pregrabado tras 0,4 segundos de inactividad. El clip tiene que sonar como Déblo, no como un segundo asistente que interrumpe. Generamos seis clips cortos con Gemini 3.1 Flash TTS, usando las mismas voces predefinidas que las sesiones en vivo: Charon para K-12, Enceladus para Pro y Companion, Orus para el asistente personal, cada una en francés y en inglés. Son archivos Opus de entre 4,3 y 5,2 segundos, decodificados a 24 kHz. Generarlos costó unos céntimos.
El texto en francés es "Je vérifie ça avec mes ressources étendues, j'ai la réponse dans quelques secondes." (Lo compruebo con mis recursos ampliados, tendré la respuesta en unos segundos.) El inglés: "Let me check that with my extended resources, I'll have your answer in a few seconds." (Déjame comprobarlo con mis recursos ampliados, tendrás tu respuesta en unos segundos.)
Tres reglas rigen cuándo se reproduce:
- Se omite si el modelo ya habló desde el final de la última intervención del usuario. A veces el modelo sí se anuncia, o una herramienta anterior de la misma cadena ya fue anunciada. El final de la voz del usuario lo da el VAD del lado del servidor, con la transcripción final como respaldo.
- Sin clip, no hay anuncio. Una voz o un idioma sin clip correspondiente no recibe nada (solo la señal 2). Nunca una voz equivocada, nunca un idioma equivocado.
- Solo hablado. El anuncio se reproduce con
add_to_chat_ctx=False, así que nunca entra en el contexto de Gemini ni en la transcripción guardada de la conversación.
El clip se pasa a session.say() como tramas de audio ya decodificadas, de modo que no se ejecuta ningún TTS en el momento de la llamada.
Señal 2: un suave sonido de tecleo mientras el agente piensa
El anuncio cubre unos cinco segundos. El resto de la espera necesitaba otra cosa. Añadimos un bucle discreto de tecleo en una pista de audio separada (BackgroundAudioPlayer), activo mientras el agente está en el estado thinking.
Antes de apoyarnos en ese estado, leímos el código fuente del SDK 1.8.5: en la ruta realtime, el agente entra en thinking solo mientras se ejecuta una herramienta de función y hasta que el modelo empieza a pronunciar la respuesta. Nunca entra en él en un turno conversacional ordinario. Eso convertía el estado en un disparador fiable para todas las herramientas de función, no solo para deep_think.
Los detalles que más cuidado requirieron:
- Silenciado mientras el usuario habla. El SDK permanece en
thinkingdurante una interrupción (barge-in) mientras siga ejecutándose una herramienta. Teclear sobre la voz de alguien es ruido, así que el sonido se detiene cuando el usuario empieza a hablar y se reanuda cuando se calla. - Fundido de entrada de un segundo. Las herramientas rápidas terminan antes de que el sonido sea audible, así que siguen en silencio.
- Límite estricto de 30 segundos. Si el estado se queda atascado en
thinking, el bucle se detiene y lo registra.
Elegimos el tecleo en lugar de música de espera. Es más discreto y se percibe como "estoy trabajando en ello" en lugar de "usted está en espera".
Sin nueva versión del cliente
Ninguna de las dos señales exigió una nueva versión de la aplicación. El cliente web ya adjunta todas las pistas de audio remotas, y la aplicación móvil las enruta de forma nativa. Ambas señales viajan en pistas que los clientes ya reproducían. Tres variables de entorno permiten desactivar cada señal o cambiar el volumen sin redesplegar código.
La trampa con la que casi desplegamos
Antes de hacer push, comprobamos qué versión del SDK se ejecutaba realmente en producción, leyendo pip freeze dentro del contenedor del worker. Respuesta: livekit-agents 1.8.5, imagen construida el 7 de octubre.
Luego miramos requirements.txt. Decía livekit-agents>=1.5.0. Cada reconstrucción en nuestra plataforma de alojamiento resolvía a la última versión. La versión 1.8.8 se había publicado ese mismo día. Nuestro arreglo de voz, escrito y verificado contra la 1.8.5, se habría desplegado junto con un salto de SDK no probado, y el worker hace monkey-patching de partes internas del SDK. Si algo se hubiera roto, habríamos culpado al arreglo.
Fijamos los seis paquetes de LiveKit y Google a las versiones exactas de producción, y añadimos un constraints.txt con los 89 paquetes del freeze de producción, aplicado por el Dockerfile. Una resolución en seco para Linux x86_64 produjo exactamente esos 89 paquetes y ningún otro. El push no cambió ninguna dependencia.
La auditoría, y lo que cambió
Antes del push, un agente de auditoría independiente, de solo lectura, revisó el cambio contra el código fuente real del SDK 1.8.5. Veredicto: GO-WITH-FIXES, sin interbloqueo ni ruta de cierre inesperado. Las correcciones que aplicamos:
- el sonido de tecleo ahora se detiene mientras el usuario habla;
- la comprobación de "el modelo ya habló" usa el final de voz del VAD en lugar de la transcripción final, que puede llegar después de que el modelo ya haya respondido;
- los listeners de eventos se dan de baja antes de cerrar el reproductor de fondo;
say()está envuelto, y el eventoplayedsolo se emite cuando existe un handle;- el
constraints.txtmencionado arriba.
Rechazamos dos de sus sugerencias, y las razones merecen conservarse:
- Elegir el idioma del anuncio a partir de la transcripción. Nuestro detector de idioma de transcripción devuelve inglés para cualquier francés escrito o transcrito sin acentos ("quelle est la derivee"). Habría producido más anuncios en el idioma equivocado de los que habría evitado. El idioma de la sesión sigue siendo la fuente.
- Subir el retardo de inactividad de 0,4 a 0,8 segundos. Cada décima de segundo añadida es silencio puro en el caso común (el modelo no dice nada) a cambio de reducir uno raro (un anuncio duplicado). Mantuvimos 0,4.
También descartamos una idea del propio informe de error: pedir confirmación al usuario antes de cada búsqueda extendida. Elimina la sorpresa, pero añade un viaje de ida y vuelta de voz completo a cada pregunta compleja. Eso cuesta más que el silencio que estábamos corrigiendo.
Prueba en producción
El 16 de octubre a las 08:20 UTC, Juste hizo una llamada desde la aplicación móvil: audiencia Pro, voz Enceladus, francés. Hizo dos preguntas que activan deep_think: la integral de x² eˣ entre 0 y 1, y la cuota mensual de un préstamo de 25 millones de FCFA al 9 % a 5 años. Nos envió los logs del worker. Los tiempos siguientes son relativos al evento tool_call:
| Integral de x² eˣ, de 0 a 1 | Préstamo 25 M FCFA, 9 %, 5 años | |
|---|---|---|
tool_filler action=played | +0,40 s | +0,41 s |
tool_success (gemini-3.8-flash) | +9,48 s | +12,55 s |
| Empieza la respuesta hablada | +14,12 s | +17,47 s |
| Silencio realmente percibido | unos 0,4 s | unos 0,4 s |
Los eventos relevantes de la primera llamada, reconstruidos y abreviados, sin identificadores:
textsession.tool_call      tool=deep_think
session.tool_pre_speech tool=deep_think  no_pre_speech=true
session.tool_filler    tool=deep_think  action=played  voice=Enceladus  lang=fr
session.tool_success   tool=deep_think  model=gemini-3.8-flash
En la primera llamada el modelo dio no_pre_speech: true: llamó a la herramienta sin decir una palabra, que es exactamente el caso del informe de error. El anuncio se reprodujo. No hubo ningún thinking_sound_error, ningún thinking_sound_capped, ningún filler omitido ni en error.
Las palabras del propio Juste: « j'ai entendu l'audio en fond sonore comme si on tapait sur le clavier et je n'ai même pas remarqué de délai d'attente » (oí el audio de fondo, como si alguien tecleara, y ni siquiera noté que hubiera una espera).
Las respuestas también fueron correctas: e − 2 para la integral, y una cuota mensual de 518.959 FCFA (valor exacto 518.958,88). El interés total que anunció, 6.137.634 FCFA frente a 6.137.533 exactos, se desvió en 101 FCFA, un redondeo del modelo.
Una nota honesta sobre esa tabla: el silencio del lado del modelo es ahora más largo que en mayo, no más corto. Producción ejecuta deep_think con gemini-3.8-flash, que tarda entre 9,5 y 12,5 segundos en ejecutarse (frente a 4 a 7 con la 3.5), aunque el modelo en vivo retoma más rápido (de 4,6 a 4,9 segundos, frente a 7). El 16 de octubre Juste decidió mantener la 3.8: la exactitud antes que la latencia. Ese compromiso se volvió aceptable gracias a las señales. Una espera de 17 segundos en la que se oye que se está trabajando es un producto distinto de una espera de 17 segundos en silencio.
Lo que sigue abierto
Marcamos el arreglo como probado en móvil, no en todas partes:
- La prueba en web sigue pendiente. El cliente del navegador adjunta todas las pistas de audio remotas, así que el riesgo es bajo, pero aún no lo hemos observado.
- Eco en altavoces potentes. Aún tenemos que confirmar en un dispositivo real que el sonido de tecleo no puede activar la detección de voz de Gemini a través de la cancelación de eco del teléfono.
- Transcripciones tardías. Si la transcripción final del usuario llega después de que el modelo se haya anunciado, el anuncio pregrabado puede duplicarlo. Coste: una frase redundante.
- Herramientas rápidas. Si la herramienta responde en menos de cinco segundos, la respuesta espera a que termine el anuncio: hasta unos 1,6 segundos más.
- Nuestra propia métrica ahora es errónea.
total_silence_ssolo cuenta la voz del modelo, así que reporta de 14 a 17 segundos en llamadas en las que el usuario oyó 0,4. Hay que recalibrarla.
Lecciones para quienes construyen voz en tiempo real
- Mide dónde va el primer token antes de escribir instrucciones de prompt sobre él. Si un modelo de audio nativo emite primero la llamada a función, ninguna instrucción pondrá habla delante de ella.
- Descompón el silencio. El nuestro tenía una parte de herramienta y una parte de respuesta. Un arreglo dirigido solo a una de ellas parece correcto en revisión y falla en el oído del usuario.
- Pon las garantías que percibe el usuario en código que controlas. El worker sabe cuándo empieza una herramienta, cuándo la sesión está inactiva y cuándo habla el usuario. Puede hacer promesas que el modelo no puede.
- Usa la propia voz de la sesión para el relleno. Un clip pregrabado con la misma voz predefinida suena como el asistente, no como un mensaje grabado.
- Fija lo que producción ejecuta realmente y luego demuestra que la fijación se sostiene. Lee el freeze desde el contenedor, restríngelo y resuélvelo en seco antes de subir cualquier otra cosa encima.
- Rechaza las sugerencias de una auditoría con una razón, por escrito. Dos de las ideas del auditor habrían empeorado el producto. Decir por qué es lo que impide que vuelvan.